蛋白质模拟的标准流程
获取结构:通常在RCSB等数据库或者课题合作者处获取pdb文件,也可以用Modeller等工具做同源模建等方式建立,或者通过AlphaFold、Robetta等基于序列直接预测结构
- 数据库中:解析度 1.8埃已经足够好。—般建议尽量用解析度不超过 2.5埃的结构,>3.0埃的使用则须谨慎。
对pdb文件进行预处理
- 拿到pdb后,应检查一遍REMARK字段,看有无非标准残基、配体,有无原子缺失。然后做以下步骤对结构预处理
- 删除X光测定的pdb中带的少量结晶水(在pdb文件末尾),关键位点的则保留
- NMR测定的pdb含多帧时,选取要用的帧而去除其它的(要用的是第一帧的话可以不用删其它帧)
- 在pdb中搜索missing:补全关键性的缺失残基、补全个别残基缺失原子
- 拿到pdb后,应检查一遍REMARK字段,看有无非标准残基、配体,有无原子缺失。然后做以下步骤对结构预处理
产生拓扑文件(pdb2gmx)
1
gmx pdb2gmx -f protein.pdb -o protein.gro -p topol.top -ignh
设置盒子(editconf)
1
gmx editconf -f protein.gro -o protein_box.gro -d 0.8 -bt cubic
加水(solvate)
1
gmx solvate -cp protein_box.gro -o protein_SOL.gro -p topol.top
1
gmx grompp -f em.mdp -c protein_SOL.gro -p topol.top -o em.tpr -maxwarn 1
加抗衡离子(genion)
1
gmx genion -s em.tpr -p topol.top -o system.gro -neutral
能量极小化
1
2
3
4
5
6
gmx grompp -f em.mdp -c system.gro -p topol.top -o em.tpr -maxwarn 1
gmx mdrun -v -deffnm em
gmx grompp -f step6.0_minimization.mdp -o step6.0.tpr -c step5_input.gro -r step5_input.gro -p topol.top -n index.ndx对蛋白质施加限制势做短时间动力学模拟,以令溶剂充分弛豫
1
2
gmx grompp -f pr.mdp -c em.gro -p topol.top -r em.gro -o pr.tpr -maxwarn 1
gmx mdrun -v -deffnm pr长时间动力学模拟
1
2
gmx grompp -f md.mdp -c pr.gro -p topol.top -o md.tpr -maxwarn 10
gmx mdrun -v -deffnm md分析轨迹和能量文件
轨迹去水
1
2
3
gmx trjconv -f md.xtc -s md.tpr -o md_nowat.xtc
gmx trjconv -f md.gro -s md.tpr -o md_nowat.gro
选择组的时候non-waterRMSD分析
1
gmx rms -f md.xtc -s md.tpr -o rmsd_protein.xvg
RMSF分析
1
gmx rmsf -f md.xtc -s md.tpr -o rmsf_protein.xvg -oq bfac.pdb -res -b 250
Ramachandran 图
1
gmx rama -f md.xtc -s md.tpr
二级结构的变化
1
gmx dssp -f md.xtc -s md.tpr
溶剂可及表面积
1
gmx sasa -f md.xtc -s md.tpr -surface "group protein" -output ' "Hydrophobic" group protein and charge {-0.2 to 0.2}; "Hydrophilic" group protein and not charge {-0.2 to 0.2}'
残基间的距离矩阵
1
gmx mdmat -f md.xtc -s md.tpr (选择Protein)
组间最小接触距离随时间变化
1
gmx pairdist -f md.xtc -s md.tpr -ref "resid 21" -sel "resid 29"
1UBQ 泛素
泛素(ubiquitin)是一种存在于大多数真核细胞中的小蛋白。它的主要功能是标记需要分解掉的蛋白质,使其被水解。
获取结构
下载了pdb后,在vmd中打开
- 对`oxygen and numbonds=0`用VDW方式显示可以清楚看到当前体系里的结晶水
对其它体系,也可以用not protein快速直观检查体系里都有什么
通过B因子进行着色:

尾部残基B因子很大,而且pdb文件中其occupancy远小于1,测定精度很低。但由于在末端所以无所谓。
对pdb文件进行预处理
- 建立1UBQ目录
- 将1ubq.pdb文件中第一个残基名为HOH的行到末尾处都删除以去掉所有结晶水
- 由于此蛋白尾部链很长,不仅测定精度低,对主体结构也没什么直接影响,还导致模拟时候需要用明显更大的盒子,所以这里索性把72号残基及后面的部分也删除
- 保存为protein.pdb放到1UBQ目录下
产生拓扑文件(pdb2gmx)
产生拓扑文件:
1
gmx pdb2gmx -f protein.pdb -o protein.gro -p topol.top
力场选择14:GROMOS96 54a7 force field
水型选择1: SPC simple point charge, recommended
之后得到了topol.top、protein.gro和posre.itp(提供限制势)
- posre.itp主要是对非氢原子(重原子)的x、y、z方向都增加很大的谐振限制势,用来限制蛋白质的坐标不发生改变
过程中的一些输出:
pdb2gmx默认根据TER标记以及链ID的变化判断有几条链。目前判断只有一条链,含71个残基
1
2
3
4
5
6
7
Splitting chemical chains based on TER records or chain id changing.
There are 1 chains and 0 blocks of water and 71 residues with 563 atoms
chain #res #atoms
1 'A' 71 563
All occupancies are oneHIS的质子化态比较模棱两可,pdb2gmx根据氢键判断HIS最适合的质子化态。当前体系68号残基是HIS,被pdb2gmx判断为了HISE,即只在E位有氢,不带电荷

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
Processing chain 1 'A' (563 atoms, 71 residues)
Analysing hydrogen-bonding network for automated assignment of histidine
protonation. 105 donors and 112 acceptors were found.
There are 166 hydrogen bonds
Will use HISE for residue 68
Identified residue MET1 as a starting terminus. 判断端基
Identified residue LEU71 as a ending terminus. 判断端基
8 out of 8 lines of specbond.dat converted successfully
Special Atom Distance matrix:
MET1
SD7
HIS68 NE2540 1.621
Start terminus MET-1: NH3+ 端基默认当成带电状态
End terminus LEU-71: COO-
Checking for duplicate atoms....
Generating any missing hydrogen atoms and/or adding termini.
Now there are 71 residues with 709 atoms 给端基按照.tdb里的规则加氢下列端基warning只对gromos力场出现,不用管:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
WARNING: WARNING: Residue 1 named MET of a molecule in the input file was mapped
to an entry in the topology database, but the atom H used in
an interaction of type angle in that entry is not found in the
input file. Perhaps your atom and/or residue naming needs to be
fixed.
WARNING: WARNING: Residue 71 named LEU of a molecule in the input file was mapped
to an entry in the topology database, but the atom O used in
an interaction of type angle in that entry is not found in the
input file. Perhaps your atom and/or residue naming needs to be
fixed.
Before cleaning: 1212 pairs
Before cleaning: 1456 dihedrals
Making cmap torsions...
There are 538 dihedrals, 314 impropers, 1036 angles
1212 pairs, 715 bonds and 0 virtual sites
Total mass 8023.226 a.m.u.
Total charge -2.000 e 体系净电荷为-2, 需要加抗衡离子
Writing topology
设置盒子(editconf)
1 | gmx editconf -f protein.gro -o protein_box.gro -d 0.8 -bt cubic |
- 默认设置下会产生矩形盒子。此时应注意若体系本身偏离球形很多,且在模拟过程中发生了旋转,则可能会与镜像发生 相互作用。像此例用立方 (cubic) 盒子则不用担心这个问题 。 如果对蛋白质设置消除整体转动,用矩形盒子也完令没问题 。
加水(solvate)
1 | gmx solvate -cp protein_box.gro -o protein_SOL.gro -p topol.top |
临时tpr文件:
1 | gmx grompp -f em.mdp -c protein_SOL.gro -p topol.top -o em.tpr -maxwarn 2 |
添加 Na+离子使体系中性化
1 | gmx genion -s em.tpr -p topol.top -o system.gro -neutral |
选择13:SOL,替换掉两个水
也可以加上-conc 0.1 来额外加入 NaCl使得盐浓度和生理环境0.15 M 一致,原理上会更好
能量极小化
1 | gmx grompp -f em.mdp -c system.gro -p topol.top -o em.tpr -maxwarn 1 |
做能量极小化。并不需要收敛得很精确,上限设1000步就够
em.mdp(能量极小化的参数文件)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19define = -DFLEXIBLE
integrator = cg ; 用cg方法能量极小化
nsteps = 1000 ; 在能量最小化中, 指定最大迭代次数
emtol = 100.0 ; 能量最小化收敛限
emstep = 0.01 ; 初始步长(nm)
;
nstxout = 20 ; 输出到trr文件频率
nstlog = 50 ; log文件输出频率
nstenergy = 50 ; 能量写出频率
;
pbc = xyz ; 3维周期性边界条件
cutoff-scheme = Verlet
coulombtype = PME
rcoulomb = 1.0
vdwtype = Cut-off
rvdw = 1.0
DispCorr = EnerPres
;
constraints = none
对蛋白质限制性MD
对蛋白原子做限制性动力学,使得水弛豫开之前蛋白质结构不会明显发生改变以免构象出现可能的破坏
1 | gmx grompp -f pr.mdp -c em.gro -p topol.top -r em.gro -o pr.tpr -maxwarn 1 |
top文件包含了:可以看到.top里对位置限制文件进行了引用,但需要通过在mdp里设定define=-DPOSRES使之生效
1
2
3
4; Include Position restraint file
pr.mdp
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
define = -DPOSRES
integrator = md
dt = 0.002 ; ps
nsteps = 50000 ; 100ps #水的弛豫比较快,100ps就可以了
...
Tcoupl = V-rescale
tau_t = 0.2
tc_grps = system
ref_t = 298.15 #常温
;
Pcoupl = Berendsen
pcoupltype = isotropic
tau_p = 0.5
ref_p = 1.0 #常压
compressibility = 4.5e-5
;
freezegrps =
freezedim =
constraints = hbonds #跟氢原子有关的键长都约束住有时模拟初期会有一些LINCS warning,只要之后不再出现就不用管。如果一直频繁
出现LINCS warning,甚至导致模拟结果异常、崩溃,可以优先考虑把步长改小为1
fs再试
正式动力学模拟
1 | gmx grompp -f md.mdp -c pr.gro -p topol.top -o md.tpr -maxwarn 10 |
md.mdp
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35define =
integrator = md
dt = 0.002 ; ps
nsteps = 1000000 ; 2ns
comm-grps = protein
comm-mode = angular
energygrps =
;
nstxout = 0
nstvout = 0
nstfout = 0
nstlog = 5000
nstenergy = 1000
nstxout-compressed = 1000 ;每1000步写入一次xtc轨迹
compressed-x-grps = system
;
pbc = xyz
cutoff-scheme = Verlet
coulombtype = PME
rcoulomb = 1.0
vdwtype = cut-off
rvdw = 1.0
DispCorr = EnerPres
;
Tcoupl = V-rescale
tau_t = 0.2 0.2 #蛋白质和非蛋白质部分要分两个部分控温
tc_grps = protein non-protein
ref_t = 298.15 298.15
;
Pcoupl = parrinello-rahman
pcoupltype = isotropic
tau_p = 2.0
ref_p = 1.0
compressibility = 4.5e-5
...如今做蛋白质动力学都最起码跑10ns,为了省时间这里只跑2ns。
生物分子模拟温度用298.15K、300K或者体温310K都有,用哪个皆可,对结果影响不大。
默认是对整个体系消除平动,但是对于模拟生物大分子,在模拟中往往发现生物大分子会移动、旋转,给观看带来不便。所以此.mdp中对Protein组使用
comm-mode=angular来消除其平动和转动。但需要用-maxwarn来忽略由此造成的多余的警告。如果不靠angular消除蛋自整体运动,模拟完后用
trjconv后处理轨迹也行。先将蛋自居中并修正周期性:1
gmx trjconv -f md.xtc -s md.tpr -o cen.xtc -center -pbc mol
其中centering组选Protein,输出组选整体。之后再消除蛋白的平动和转动:
1
gmx trjconv -f cen.xtc -s md.tpr -fit rot+trans -o fit.xtc
其中least squares fit组和输出组都选Protein
蛋白质和非蛋白质部分要分两个部分控温,否则两个会温差过大
- 水和离子要放在一起控温,因为它们能量交换比较频繁
分析轨迹
去除水的轨迹
轨迹中感兴趣的通常只是蛋白部分,水原子数远比蛋自多却不是感兴趣的。为了节约硬盘,同时也降低在VMD中载入的耗时和内存占用,可以转化出一份不含水的结构文件和轨迹文件而把原轨迹删掉,这样文件体积比原先往往小一个数量级:
1 | gmx trjconv -f md.xtc -s md.tpr -o md_nowat.xtc |
- 如果想在做动力学的时候就只把非水部分写入轨迹文件中,可以mdp中设
compressed-x-grps = non-water
检查蛋白与其镜像距离
mindist命令的-pi选项可以考察选定的组与它周期镜像间最远和最近距离。如果模拟盒子边界延展距离设得比较小,为保险起见可以用以下命令检验一下整个轨迹中蛋白质与其镜像间的最近距离,如果出现了距离小于非键作用cutoff的情况则轨迹就可能有虚假性。
1 | gmx mindist -f md.xtc -s md.tpr -pi |
可以绘图:
1 | xmgrace mindist.xvg |

- 如果加上
-nxy,则镜像间最小距离、当前组内原子间最远距离,以及盒子X/Y/Z尺寸随时间的变化都会被同时绘制出来
考察蛋白质的RMSD
运行以下命令,计算轨迹中每一帧的结构和参考结构(-s提供的结构文件)间的质量权重的RMSD:
1 | gmx rms -f md.xtc -s md.tpr -o rmsd_protein.xvg |
要叠合的组,和要计算RMSD的组都选Protein。
绘制成RMSD曲线图
1
xmgrace rmsd_protein.xvg
如果不想考虑质量权重,应额外加上
-nomw选项。

相对于第1帧结构(限制性动力学后的结构)的蛋白质的RMSD曲线对于检验蛋白质结构在模拟过程中是否已经趋于稳定极为关键。当RMSD曲线变化整体上看已经趋于水平,就可以认为己经达到平衡。
对于生物大分子体系,整个体系的温度、密度、总能量等收敛速度远快于蛋白质结构的RMSD,所以看那些对于判断蛋白质平衡毫无用处。
平衡后的RMSD值越大,整体偏离初始结构越大。刚性体系会比柔性体系RMSD小得多
Analysis - RMSD Trajectory Tool
利用VMD也可以绘制RMSD曲线、绘制每个残基的RMSD对总RMSD的贡献

考察RMSF和B因子
运行以下命令,并且选Protein。由于模拟前期明显还未平衡,所以从250ps开始统计
1 | gmx rmsf -f md.xtc -s md.tpr -o rmsf_protein.xvg -oq bfac.pdb -res -b 250 |
- 程序会把轨迹中的蛋白冲着md.tpr中的结构叠合,然后计算原子的RMSF,之后把每个残基中的各原子的RMSF取平均作为残基的RMSF输出到mmsf_protein.xvg中。
-oq要求还使得md.tpr里的蛋白质结构带着计算出的B因子(残基内各原子取平均)写入到bfac.pdb中。 - 不写
-res则输出原子的RMSF和B因子。 - 在VMD中以B因子着色显示bfac.pdb,可以考察模拟中不同区域波动程度,越红(越蓝)波动越小(越大)

- beta折叠、alpha螺旋这样的稳定二级结构中残基的B因子一般都很小
- 波动显著。在Timeline的RMSD图上此残基数值变化也很大。
绘制 Ramachandran 图
1 | gmx rama -f md.xtc -s md.tpr |

- 使用VMD也可以绘制rama图
分析骨架 psi 、 phi 角度
- GROMACS的
chi命令可以对蛋白质骨架二面角作分析 - 用VMD的Timeline工具也可以,能计算的包括:
- Calc. Phi/Psi:计算各残基Phi/Psi角度随时间的变化
- Calc. delta Phi/Psi:计算各残基Phi/Psi角度相对于第一帧时的变化
考察二级结构的变化
运行以下命令并选Protein组
1 | gmx dssp -f md.xtc -s md.tpr |
得到的scount.xvg中记录了各个时刻形成不同二级结构的残基数,运行以下命令绘制之:
1 | xmgrace -nxy scount.xvg |

也可以通过glpt程序绘制:
安装使用教程:Description — gplt 0.1.12 documentation
1 | pip install numpy matplotlib colorama pandas openpyxl |

- 利用 VMD 的 Timeline工具也可以绘 制 二级结构随 时间变化。
选Cale Sec. Struct.
考察SASA
- 使用sasa命令可以考察蛋白的溶剂可及表面积。
1 | gmx sasa -f md.xtc -s md.tpr -surface "group protein" -output ' "Hydrophobic" group protein and charge {-0.2 to 0.2}; "Hydrophilic" group protein and not charge {-0.2 to 0.2}' |

在VMD中也可以计算总的以及亲水、疏水部分的SASA,但VMD中是按照残基类划分的,因此和GROMACS的SASA命令结果有出入。ALA、LEU、VAL、ILE、PRO、PHE、MET、TRP被当成疏水残基。
1
2
3set protein [atomselect top "protein"]
set phob [atomselect top "hydrophobic"]
set phil [atomselect top "not hydrophobic'"]获得蛋白疏水部分的SASA:
1
measure sasa 1.4 $protein -restrict $phob
获得蛋白亲水部分的SASA:
1
measure sasa 1.4 $protein -restrict $phil
这样得到的两部分结果相加等于蛋白质总SASA:
1
measure sasa 1.4 $protein
只计算非极性侧链的SASA:
1
measure sasa 1.4 [atomselect top "sidechain"] -restrict [atomselect top "hydrophobic"]
利用VMD\scripts\proteinSASA.tcl可计算所有帧的SASA。并行计算脚本:并行计算溶剂可及表面积(SASA)的VMD脚本sasa-dmp.tcl - 分子模拟 (Molecular Modeling) - 计算化学公社
分析残基间的距离矩阵
1 | gmx mdmat -f md.xtc -s md.tpr (选择Protein) |
- VMD也可以:Extensions-Analysis - Contact Map。选择Calculate-Calc.res-res Dists后它会计算残基之间Alpha碳的距离并显示在图中。黑色为0埃,白色对应大于10埃。
分析氢键
建立hbond目录,进入其中
1 | gmx hbond -f ../md.xtc -s ../md.tpr -dist -ang -life -nhbdist |
- 可以选择两次Protein分析蛋白内氢键整体特征和数目
- 也可以选Protein然后SOL分析蛋白质与水之间的氢键整体特征。
- 注:当前分析目的是考察氢键总数,是否加
-nomerge并不影响氢键总数
使用 hbond 工具可以对此氢键特征做统计。 在 hbond 目录下输入:
1 | gmx make_ndx -f ../md.gro |
然后输入以下命令 , 并选择刚设的两个组
1 | gmx hbond -f ../md.xtc -s ../md.tpr -dist -ang -life -nhbdist -hbm -n index.ndx |
氢键平均寿命 (SPC/E纯水为3.1 ps) :
1 | HB lifetime= 9.50 ps |
(由于当前分析的氢键不涉及一个氢键给体原子 上多个氢同时和一个氢键受体原子形成氢键,所 以加不加-nomerge 不影响结果)
使用以下命令获得氢键存在性图像文件plot.eps
1 | gmx xpm2ps -f hbmap.xpm -noframe -by 50 -bx 1 |
也可以把 hbnum.xvg 里的前两列数据导入到 Origin 里,只对 数值为 1 的时刻绘制散点图,散点符号用 I, 可得到类似效果。
分析盐桥
- 用VMD的Extensions-Analysis -Salt Bridges插件可以搜索出体系中所有正电残基
蛋白质骨架运动的可视化
要对backbone做过叠合。且要用Tachyon渲染


残基运动的可视化


考察残基间的距离与接触
考察模拟过程中ASP21和LYS29间最小距离随时间的变化,以及两个组的原子间距离小于指定距离(-d指定)的原子对数随时间的变化:
首先构建包含这两个残基的索引文件
1
gmx make_ndx -f md.gro
输入r21和r29,然后按q。
之后运行
1
gmx mindist -f md.xtc -s md.tpr -n index.ndx -d 0.5 -on
依次选择r_21和r_29
如果接
-o,还会输出atm-pair.out,显示不同时刻两个组间相距最近的原子的编号。mindist.xvg 是两个组之间原子间 最近距离随时间的变化
numcont.xvg 是两个组之间原子间距离小于
-d指定的距离的原子对数 若不需要此数据则 mindist不需 要写-on如果加上
-or选项,mindist还会输出第二个组与第一个组当中各个残基在轨迹中最近的距离,记录到mindistres.xvg中。例如考察4147号NA离子与蛋白中各个残基在模拟过程中最近距离,先在index.ndx末尾加入
1
2[4147NA]
4147然后运行
1
gmx mindist -f md.xtc -s md.tpr -n index.ndx -or
选择Protein,再选择4147NA
通过pairdist也可以实现mindist功能,且更为灵活
例:计算21和29号残基最小距离随模拟时间的变化
1
gmx pairdist -f md.xtc -s md.tpr -ref "resid 21" -sel "resid 29"
得到的dist.xvg与mindist得到的mindistxvg相同。
测量残基质心、几何中心间的距离变化
考察21与29号残基间质心距离随时间的变化
1
gmx distance -s md.tpr -f md.xtc -select "com of resid 21plus com of resid 29" -oall
输出了平均值、标准偏差,同时得到distxvg(因用了
-oal)考察21号残基与蛋白质几何中心距离随时间的变化
1
gmx distance -s md.tpr -f md.xtc -select "cog of resid 21 pluscog of group ""protein"" -oall
亦可用卢天的comdist.tcl脚本来计算质心距离,结果与distance命令相同。
pairdist命令也可以
1
gmx pairdist -f md.xtc -s md.tpr -ref "com of resid 21" -sel "com of resid 29"
考察螺旋的基本结构参数
新建自录helix,进入其中
构建索引文件:
1
2gmx make_ndx -f ../md.gro
选q计算螺旋参数,会产生大量文件
1
gmx helix -f ../md.xtc -s ../md.tpr -n index.ndx
由于当前体系就一个螺旋,所以直接选Protein即可,程序也确实判断对了组成螺旋的残基:
1
helix from: 23 through 34
也可以人为用
-ahxstart和-ahxend指定螺旋中第一个和最后一个残基号。
螺旋弯曲度的分析
VMD-Extensions-Visualization-Bendix

考察蛋白质表面附近水的分布
1 | gmx rdf -f md.xtc -s md.tpr -ref protein -sel "mol com of resname SOL" -surf mol -rmax 1 |
由于当前盒子较大,要求计算到1nm距离足矣,没必要计算不感兴趣的更远的地方白浪费时间。
研究高温对蛋白质的影响
接续之前298.15K的最终状态做400K的动力学。
建立400K子目录,将md.mdp拷入其中,把温度改成400K,时间设5ns。在此目录中运行以下命令:
1 | gmx grompp -f md.mdp -c ../md.gro -p ../topol.top -o md.tpr -t ../mnd.cpt -maxwarn 10 |
按照之前的做法计算RMSF,与298.15K下的情况进行对比。
钙调素 (2BBM) 的模拟-含离子
钙调素(calmodulin,CaM)是一种广泛存在于真核细胞内的蛋白质,钙离子调节细胞的功能很大程度上是通过钙调素作为受体来实现的。钙调素参与了细胞内众多生命现象的发生与调节。
钙调素的一大特点是结合钙离子后构象会发生变化,产生活性。通过此机理钙调素对细胞进行调控。
结合钙离子后的活化钙调素会与受体蛋白质相结合,从而使蛋白质的功能得到表达,目前已知钙调素有30多种靶蛋白或者靶酶。
许多细菌和病毒也是依靠钙调
素来表达它们的毒性。
癌细胞对钙调素也有重要的依赖作用。有研究表明,在缺少钙调素的情况下,癌细胞会在短时间内死亡。
对pdb文件进行预处理

- pdb中钙离子残基名为CA,然而在要用的G54A7力场rtp文件中钙离子残基名为CA2+,因此需要做以下替换后保存。
- pdb中搜不到missing段落,REMARK中也没其它重要提示,此时可以直接模拟
产生拓扑文件(pdb2gmx)
1 | gmx pdb2gmx -f protein.pdb -o protein.gro -p topol.top -ignh |
- 由于 NMR测定的结构中氢的原子名往往不标准导致 pdb2 卯 x 无法解析,因此用- ignh 忽略掉所有氢。
力场选择14:GROMOS96 54a7 force field 、水型选择1: SPC simple point charge, recommended,产生的文件:
- topol_Other.itp:4个Ca2+
- topol_Protein_chain_A.itp:钙调素的蛋白部分
- topol_Protein_chain_B.itp:插入的小肽
设置盒子(editconf)
1 | gmx editconf -f protein.gro -o protein_box.gro -d 0.8 -bt cubic |
加水(solvate)
1 | gmx solvate -cp protein_box.gro -o protein_SOL.gro -p topol.top |
临时tpr文件:
1 | gmx grompp -f em.mdp -c protein_SOL.gro -p topol.top -o em.tpr -maxwarn 2 |
添加离子使体系中性化
1 | gmx genion -s em.tpr -p topol.top -o system.gro -neutral |
选择水替换掉
能量极小化
1 | gmx grompp -f em.mdp -c system.gro -p topol.top -o em.tpr -maxwarn 1 |
对蛋白质限制性MD
100ps:
1 | gmx grompp -f pr.mdp -c em.gro -p topol.top -r em.gro -o pr.tpr -maxwarn 1 |
正式动力学模拟
1ns
1 | gmx grompp -f md.mdp -c pr.gro -p topol.top -o md.tpr -maxwarn 10 |
分析
注:钙离子用resname’CA2+’语句来选择
可以用 0:10:500叠加显示钠和钙离子分布特征差异

选中距离 1751 号或 1752 号原子 4 埃(Å)范围内的所有氨基酸残基,并且只显示这些残基的侧链(不包含主链)
1
sidechain and same residue as within 4 of index 1751 1752
使用以下脚本,统计平均每个钙离子附 近4 埃内蛋白质上的氧的原子数目.
1
2
3
4
5
6
7
8set result [open num.txt w]
set sel [atomselect top "oxygen and protein and within 4 of resname 'CA2+'"]
for {set i 0} {$i<=500} {incr i 1} {
$sel frame $i
$sel update
puts $result "$i [expr double([$sel num])/4]"
}
close $result- 热运动以及水分子与钙离子的作用等原因导致蛋白质对钙离子的吸引在一开始被略微削弱,但钙离子还是始终被蛋白牢牢结合住
- 对于过渡金属配合物,单靠静电相互作用描述配位作用可能导致离子跑掉,或者配位区域结构不合理,往往需要在拓扑文件中加入成键项或限制势维持之。
蜘蛛毒素 (1OMB) 的模拟-含二硫键
蜘蛛毒素是蜘蛛产生的一类蛋白,起到神经毒素
的效果。1OMB是NMR测定的一种蜘蛛毒素的结构文件,其中有多个二硫键。
对pdb文件进行预处理
MISSING信息
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24REMARK 465 MISSING RESIDUES #此体系缺残基,但都是末端的,缺了无所谓
REMARK 465 THE FOLLOWING RESIDUES WERE NOT LOCATED IN THE
REMARK 465 EXPERIMENT. (RES=RESIDUE NAME; C=CHAIN IDENTIFIER;
REMARK 465 SSSEQ=SEQUENCE NUMBER; I=INSERTION CODE.)
REMARK 465 RES C SSSEQI
REMARK 465 GLU A 1
REMARK 465 ASP A 2
REMARK 465 ASN A 3
REMARK 465 ARG A 39
REMARK 465 LEU A 40
REMARK 465 ILE A 41
REMARK 465 MET A 42
REMARK 465 GLU A 43
REMARK 465 GLY A 44
REMARK 465 LEU A 45
REMARK 465 SER A 46
REMARK 465 PHE A 47
REMARK 465 ALA A 48
REMARK 470
REMARK 470 MISSING ATOM #PRO38缺羧基氧!
REMARK 470 THE FOLLOWING RESIDUES HAVE MISSING ATOMS (RES=RESIDUE NAME;
REMARK 470 C=CHAIN IDENTIFIER; SSEQ=SEQUENCE NUMBER; I=INSERTION CODE):
REMARK 470 RES CSSEQI ATOMS
REMARK 470 PRO A 38 O补氧的方法:
- 用 GaussView打开 pdb文件后手动画上,得到坐标后再按照 pdb 的格式手动补到 PRO38 当中。
- 也可 以用 PDB2PQR等工具自动补上。
- 实际哪怕C端氨基酸的狻基上两个硕都没有, pdb2gmx也能够照常补上(但此例直接用 AMBER 力场会报错,它只 能补 一个氧,不过可以先借助如G54A7力场补全氧,用 pdb2gmx再次载入时再选AMBER力场).
产生拓扑文件(pdb2gmx)
1 | gmx pdb2gmx -f protein.pdb -o protein.gro -p topol.top -ignh |
- 力场选择14:GROMOS96 54a7 force field、水型选择1: SPC simple point charge, recommended
1 | 8 out of 8 lines of specbond.dat converted successfully |
程序根据各CYS的硫原子间距离根据share\gromacs\top\specbond.dat
定义的规则判断二硫键。
判断结果恰与pdb中
SSBOND段落标注的一致1
2
3
4
5
6
7
8
9
108 ;条目数
最多成特殊键的数目 参考键长 新残基名
CYS SG 1 CYS SG 1 0.2 CYS2 CYS2
CYS SG 1 HEM FE 2 0.25 CYS2 HEME
CYS SG 1 HEM CAB 1 0.18 CYS2 HEME
CYS SG 1 HEM CAC 1 0.18 CYS2 HEME
HIS NE2 1 HEM FE 1 0.2 HIS1 HEME
MET SD 1 HEM FE 1 0.24 MET HEME
CO C 1 HEME FE 1 0.19 CO HEME
CYM SG 1 CYM SG 1 0.2 CYS2 CYS2- 如第一条代表如果两个名为CYS的残基中的SG原子间距离在0.2nm±10%区间内,则这两个原子被视为成键,而且这两个残基都改名叫CYS2。
pdb2gmx只会对每条链之内的原子尝试判断特殊键。如果两个残基本来应该成特殊键但是没被判断在同一条链中,可以用-merge设定将多条链视为一条链,或者用-chainsep调整判断新链的规则,或调整pdb里的链名等。
后续步骤
设置盒子(editconf)
1
gmx editconf -f protein.gro -o protein_box.gro -d 0.8 -bt cubic
加水(solvate)
1
gmx solvate -cp protein_box.gro -o protein_SOL.gro -p topol.top
临时tpr文件:
1
gmx grompp -f em.mdp -c protein_SOL.gro -p topol.top -o em.tpr -maxwarn 2
中性化:
1
gmx genion -s em.tpr -p topol.top -o system.gro -neutral
能量极小化
1
2
gmx grompp -f em.mdp -c system.gro -p topol.top -o em.tpr -maxwarn 1
gmx mdrun -v -deffnm em对蛋白质限制性MD
1
2gmx grompp -f pr.mdp -c em.gro -p topol.top -r em.gro -o pr.tpr -maxwarn 1
gmx mdrun -v -deffnm pr正式动力学模拟
1
2gmx grompp -f md.mdp -c pr.gro -p topol.top -o md.tpr -maxwarn 10
gmx mdrun -v -deffnm mdGROMACS教程:漏斗网蜘蛛毒素肽的溶剂化研究:Amber99SB-ILDN力场|Jerkwin
设置盒子
1
gmx editconf -f protein.gro -o protein_box.gro -d 1.2 -bt dodecahedron
- 使用
-bt选项创建了一个菱形十二面体盒子, 因为这种盒子是接近球形, 计算效率最高. - 理论上在绝大多数系统中,
-d都不能小于0.9 nm[6], 我们使用了1.2 nm.
- 使用
1L2Y蛋白(隐式水模型)
从GROMACS 2019开始不再支持隐式溶剂模型。 跳过
1CRN蛋白(棱形十二面体)
来自阿比西尼亚白菜的种子贮藏蛋白carmbin
使用CHARMM36力场
将 file\charmm36-feb2021.ff.tgz拷到 Gromacs的 top目录下并解压
或者直接复制到当前目录下也可以用
使用
GMXLIB环境变量1
export GMXLIB=/path/to/your/my_gmx_top:$GMXLIB
根据 GROMACS手册里推荐的 CHARMM 力场下 的模拟设置,在这些 mdp里都加入
1
2vdw-modifier = force-switch
rvdw-switch = 1.0- 井对相应的设置作如下修改:
1
2
3
4rlist = 1.2
rvdw = 1.2
rcoulomb = 1.2
DispCorr = no产生拓扑文件:
1
gmx pdb2gmx -f 1CRN.pdb -o protein.gro -p topol.top -ignh
- 选择新添加的CHARMM36力场,选择TIP3P水。此时蛋白质对应CHARMM36m参数,水模型是其御用的CHARMM TIP3P
设置盒子(editconf)
1
gmx editconf -f protein.gro -o protein_box.gro -d 1.0 -bt dodecahedron
加水(solvate)
1
gmx solvate -cp protein_box.gro -o system.gro -p topol.top
当前体系恰好为电中性,所以不用加抗衡离子,能量极小化
1
2gmx grompp -f em.mdp -c system.gro -p topol.top -o em.tpr
gmx mdrun -v -deffnm em对蛋白质限制性MD
1
2gmx grompp -f pr.mdp -c em.gro -p topol.top -r em.gro -o pr.tpr
gmx mdrun -v -deffnm pr正式动力学模拟
1
2gmx grompp -f md.mdp -c pr.gro -p topol.top -o md.tpr -maxwarn 10
gmx mdrun -v -deffnm md
轨迹
不管模拟时用的是什么特征的盒子,出于效率的考虑,GROMACS内部计算时都是利用矩形盒子来考虑PBC,故产生的轨迹文件和结构文件也都是以矩形盒子的形式来记录粒子位置的。
VMD的pbcbox命令可以根据当前盒子对应的平移矢量显示出相应的三斜盒子。

现运行下面的命令修改轨迹的单胞表示:
1 | gmx trjconv -s md.tpr -f md.xtc -o md_new.xtc -ur compact -pbc mol |
亦可对gro文件也进行处理:
1 | gmx trjconv -s md.tpr -f md.gro -o md_new.gro -ur |
在VMD里载入md.gro,删除仅有的1帧后再载入mdnew.xtc并观看轨迹,可看到溶剂分子完全出现在了棱形十二面体盒子范围里。

环肽 素卡诺环素A 2KJF
环肽是环状结构的多肽,既有天然存在的也有很多被人工合成的。环的大小从几个到几百个氨基酸不等。最常见的环肽是肽链的碳端和氮端形成肽键的情况;但也有末端氨基酸与侧链相连形成环状等情况。
- 均环肽 (homodetic cyclic peptides)指仅由肽键形成环的情况,如环孢素A(cyclosporinA,一种免疫抑制剂)。
- 杂环肽(heterodeticcyclic peptides)是指除肽键外,还可能包含二硫键、酯键或其它化学键的情况。
环肽的环状结构使其对蛋白酶降解更具抵抗力,体内半衰期更长,被广泛用于开发抗癌药、抗菌药、抗病毒药等。还被作为分子探针。一些环肽具有抗菌或抗真菌活性,可用于植物保护或食品保鲜。
产生拓扑文件(pdb2gmx)
一定要用GROMACS相对较新版本,如2025,否则pdb2gmx无法正确处理环肽。此例使用2025.1,运行以下命令(此例选AMBER99SB-ildn)
1
gmx pdb2gmx -f 2KJF.pdb -o protein.gro -p topol.top -ignh
用VMD查看protein.gro,将残基号最小(1)和最大(60)的残基显示出来进行检查,可见肽键确实合理。
VMD对环肽无法显示成New Cartoon等描述二级结构的形式,但可以用ChimeraX等程序正常以New Cartoon方式显示。
蛋白质-配体复合物的模拟
AMBER(描述蛋白质)+GAFF(描述小分子)力场下蛋白质-配体拓扑文件的基本构建顺序:
- 把pdb文件中的水分子以及不需要考虑的其它配体删掉。把配体和蛋白分别保存成不同pdb文件
- 用GaussView打开配体pdb文件,考虑实际质子化态把配体的氢加好,保存为.mol2文件
- 用acpype产生配体部分的拓扑文件
- 用pdb2gmx产生蛋白部分的拓扑文件和gro文件
- 把配体的gro文件加入到蛋白的gro文件末尾
- 用genrestr命令产生配体的限制势的itp文件,并恰当引入小分子的itp文件末尾
- 把配体的itp文件引入到.top中,并设置好top中各种分子数,和gro文件对应上
- 之后加离子、加水、模拟过程和普通蛋白一样。但做限制性动力学的时候应当同时限制蛋白和配体,蛋白和配体要作为同一个控温组。
胰蛋白酶-苄眯阳离子复合物3ATL的模拟
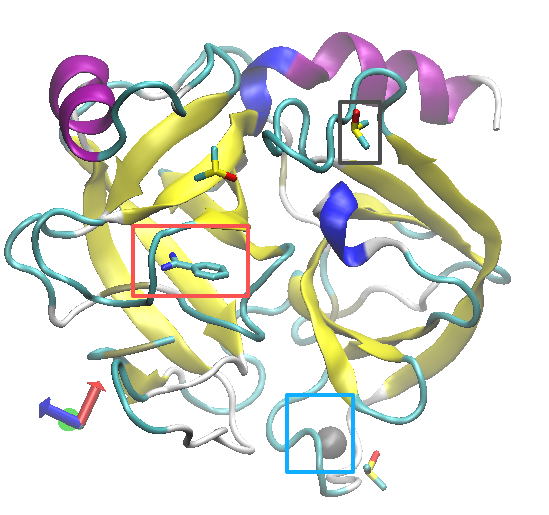
- 其中包含了Ca2+(蓝框)、DMSO(黑框)、苄眯阳离子(红框)
PDB文件的处理和拓扑文件的生成
前头标注了体系中存在的非蛋白分子的名称和数目
1
2
3
4
5
6
7
8
9
10
11
12HET CA A 1 1
HET DMS A 2 4
HET DMS A 3 4
HET DMS A 4 4
HET BEN A 5 9
HETNAM CA CALCIUM ION
HETNAM DMS DIMETHYL SULFOXIDE
HETNAM BEN BENZAMIDINE #虽然此处标记的是中性,但是实际上生理环境中是阳离子化的
FORMUL 2 CA CA 2+
FORMUL 3 DMS 3(C2 H6 O S)
FORMUL 6 BEN C7 H8 N2
FORMUL 7 HOH *317(H2 O)标注了哪些残基的哪些原子较近故可视为相连。并不影响模拟结果:
1
2
3
4
5
6
7
8
9
10
11
12SSBOND 1 CYS A 25 CYS A 155 1555 1555 2.02
SSBOND 2 CYS A 43 CYS A 59 1555 1555 2.03
SSBOND 3 CYS A 127 CYS A 228 1555 1555 2.04
SSBOND 4 CYS A 134 CYS A 201 1555 1555 2.03
SSBOND 5 CYS A 166 CYS A 180 1555 1555 2.03
SSBOND 6 CYS A 191 CYS A 215 1555 1555 2.02
LINK O VAL A 75 CA CA A 1 1555 1555 2.29
LINK OE1 GLU A 70 CA CA A 1 1555 1555 2.30
LINK OE2 GLU A 80 CA CA A 1 1555 1555 2.41
LINK O ASN A 72 CA CA A 1 1555 1555 2.43
LINK CA CA A 1 O HOH A 275 1555 1555 2.43
LINK CA CA A 1 O HOH A 313 1555 1555 2.56将Ca和蛋白质以上的部分保留,另存为protein.pbd
- 对于AMBER力场,钙离子在
tp文件里就叫CA,所以此处
不用把残基名改为CA2+
- 对于AMBER力场,钙离子在
把BEN部分另存为BEN.pbd ,用GView打开,自动加氢不合适,要手动再在N上各补一个H,另存为BEN.mol2
- 需将BEN.mol2中的Ar都替换为ar
通过acpype产生苄脒阳离子拓扑文件:
几种生成有机分子GROMACS拓扑文件的工具 - 思想家公社的门口:量子化学·分子模拟·二次元
1
./acpype.py -i BEN.mol2 -n 1 ;会生成一个BEN.acpype文件夹
为稳妥起见,最好凭化学直觉检查一下产生的.itp中的原子电荷是否合理,并且对照”GAFF原子类型.txt”检验原子类型指认是否合理。
原子电荷最好替换成自己用Multiwfn算的RESP或RESP2电荷比自动产生的AM1-BCC明显更好。RESP拟合静电势电荷的原理以及在Multiwfn中的计算 - 思想家公社的门口:量子化学·分子模拟·二次元
要先用Gaussian计算完:
# B3LYP/6-311G** em=GD3BJ opt scrf=solvent=water1
2# B3LYP/def2SVP em=GD3BJ opt=loose
# B3LYP/def2TZVP em=GD3BJ pop=MK IOp(6/33=2,6/42=6)若你计算拟合静电势电荷最终是打算结合可极化力场去用,那么拟合静电势的时候就别再用隐式溶剂模型了,因为外环境对溶质的可极化效果此时不需要由原子电荷等效地体现,而是有专门的项(如可极化偶极、Drude振子)来体现。
CHARMM/CGenFF 的电荷约定是 HF/6-31G(气相 ESP),
进入Multiwfn主功能7的子功能18(RESP计算模块)1 //计算标准RESP电荷
1
2
37
18
1
将BEN.acpype文件夹下的BEN_GMX.itp、BEN_GMX.gro复制到上一级目录下
产生蛋白质连带一个钙离子的拓扑文件:
1
gmx pdb2gmx -f protein.pdb -o protein.gro -p topol.top
- 选择AMBER99SB-ILDN力场和TIP3P水
- 得到的topol_Protein_chain_A.itp对应蛋白,topol_lon_chain_A2.itp对应钙离子。posre开头的文件对应限制势itp。
将BEN_GMX.gro加入到protein.gro的末尾,并且将第二行的原子数改为3239。保存为complex.gro。建议作图确认结构合理性
蛋白质的限制势itp文件在pdb2gmx时已产生,但小分子的还没有。genrestr是对输入的结构产生。坐标或距离限制势itp文件的工具。运行以下命令:
1
gmx genrestr -f BEN_GMX.gro -o posre_BEN.itp
选择组的时候选system。默认的位置限制势力常数是1000kJ/mol/nm2,已经足够大。
将以下语句插入到BEN_GMX.itp文件的末尾
1
2
3这样当mdp中使用define =-DPOSRES的时候配体的位置也会被限制了。
把配体的itp文件引入整体的拓扑文件topol.top,把分子数也设好
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27; Include chain topologies
; Include water topology
; Position restraint for each water oxygen
[ position_restraints ]
; i funct fcx fcy fcz
1 1 1000 1000 1000
; Include topology for ions
[ system ]
; Name
CATIONIC TRYPSIN
[ molecules ]
; Compound
Protein_chain_A 1
Ion_chain_A2 1
BEN 1- 由于BEN_GMX.itp里最开头定义了[ atomtypes ],因此此itp要最优先被引入(除非把这部分内容挪到ffnonbonded.itp里)
常规步骤
用的是protein_lig下的em.mdp、pr.mdp、md.mdp
设置盒子(editconf)
1
gmx editconf -f complex.gro -o complex_box.gro -d 1.0 -bt dodecahedron
加水(solvate)
1
gmx solvate -cp complex_box.gro -o complex_SOL.gro -p topol.top
1
gmx grompp -f em.mdp -c complex_SOL.gro -p topol.top -o em.tpr -maxwarn 1
加离子:
1
gmx genion -s em.tpr -p topol.top -o system.gro -neutral 选SOL
能量极小化
1
2
gmx grompp -f em.mdp -c system.gro -p topol.top -o em.tpr -maxwarn 1
gmx mdrun -v -deffnm em对蛋白质限制性MD 100ps
1
2gmx grompp -f pr.mdp -c em.gro -p topol.top -r em.gro -o pr.tpr
gmx mdrun -v -deffnm pr对于复杂体系,如果常规的2fs步长可能刚开始就会崩溃,可以改成更小的1fs
1
2
3
4define = -DPOSRES
integrator = md
dt = 0.001 ; ps
nsteps = 100000 ; 100ps
产生索引文件
1 | gmx make_ndx -f pr.gro |
1 | 0 System : 30629 atoms |
依次输入:(定义“蛋白-钙离子-配体”组,新的组号为24
1
1| 13 | 14
输入:(把其它部分定义为一个组,新的组号为25
1
!24
改名:
1
2
3name 24 protein_lig
name 25 envir (改名,意为“环境")
q
得到的index.ndx里的组名就和模板文件
里md.mdp中的组对应了
常规动力学1ns
1 | gmx grompp -f md.mdp -c pr.gro -p topol.top -o md.tpr -maxwarn 10 |
由于配体、钙离子与蛋白的相互作用较明显,所以此任务中它们一起作为同一个控温组和同一个消除平动转动的组。
1 | …… |
RMSD分析
蛋白质部分:两次都选backbone
1
gmx rms -f md.xtc -s md.tpr -o rmsd_protein.xvg
第一次选backbone,第二次选MOL,代表结构对蛋白骨架做叠合,但只计算MOL的RMSD,由此可考察配体分子的RMSD。
1
gmx rms -f md.xtc -s md.tpr - rmsd_lig.xvg
将蛋白质骨架做align,对配体每50帧叠加显示一次,按照Timestep着色(越红越靠前,越蓝越靠后),可直观、清楚展现配体位置和结构的波动程度。


氢键分析
取最后一帧考察:
1 | not water and same resid as within 3 of index 3228 3229 |


创建并进入hbond目录,运行
1
gmx hbond -f ../md.xtc -s ../md.tpr -hbn -hbm -nomerge
选择Protein和MOL组,得到蛋白与配体之间氢键数目随时间的变化

- 对附近20帧进行平均后:


1 | gmx xpm2ps -f hbmap.xpm -noframe -by 50 -bx 1 |
对照hbond.ndx中的[ hbonds_Protein-MOL]进行标注,有三个氢键比较稳定形成
1 | [ hbonds_Protein-MOL ] |
这个图里面的顺序和上面的顺序是相反的,从下往上


用VMD进行分析,氢键判据设置为43.1,输出:
hbonds.dat:各个时刻形成氢键的数目
hbonds-details.dat:
1
2
3
4
5
6
7Found 5 hbonds.
donor acceptor occupancy
MOL243-Side SER190-Side 62.55%
MOL243-Side GLY214-Main 89.64%
MOL243-Side ASP189-Side 224.10%
MOL243-Side CYS215-Side 0.20%
MOL243-Side GLY212-Main 0.20%- 最后一列加起来除以100,得到3.77,和gmx hbond的3.79基本吻合